Legacy BIOS
|
UEFI
|
|
發明年代
|
1975 by IBM
|
2002 by Intel
|
程式語言
|
組合語言
|
C語言
|
CPU mode
|
16-bit mode(Real mode)
|
32/64-bit
mode(Flat mode)
|
記憶體定址空間
|
~1 MB
|
>4 GB
|
支援硬碟分割格式
|
MBR
|
GPT
|
支援硬碟最大容量
|
~2 TB
|
~9 ZetaBytes
|
支援硬碟主分割區數量
|
4
|
128
|
Boot Speed
|
慢
|
快
|
Boot Manager
|
Boot loader
in MBR
|
Boot loaders
in ESP
|
硬體擴充方式
|
Option ROM
|
EFI driver
|
硬體資源控制
|
Interrupt
|
Protocol/Driver
|
安全機制
|
TPM
|
Secure Boot
|
VGA BIOS
|
VBIOS
|
GOP
|
Bootable
USB Flash drive
|
DOS
|
EFI Shell
|
2019年9月25日 星期三
UEFI和Legacy BIOS的差異

2019年6月1日 星期六
磁碟陣列 ( RAID )
磁碟陣列 ( RAID )
磁碟陣列 ( Redundant Array of Inexpensive Disks,RAID )
把多個相對便宜的硬碟組合起來,成為一個硬碟陣列組,使性能達到甚至超過一個價格昂貴、容量巨大的硬碟
根據選擇的版本不同,RAID 比單顆硬碟有以下一個或多個方面的好處:增強資料整合度,增強容錯功能,增加處理量或容量
磁碟陣列對於電腦來說, 看起來就像一個單獨的硬碟或邏輯存儲單元,分為 RAID-0,RAID-1,RAID-1E,RAID-5,RAID-6,RAID-7,RAID-10,RAID-50
RAID 把多個硬碟組合成為一個邏輯磁區,因此,作業系統只會把它當作一個硬碟,RAID 常被用在伺服器電腦上且常使用完全相同的硬碟作為組合
由於硬碟價格的不斷下降與 RAID 功能更加有效地與主機板整合,它也成為了玩家的一個選擇,特別是需要大容量儲存空間的工作
最初的 RAID 分成了不同的等級,每種等級都有其理論上的優缺點,不同的等級在兩個目標間取得平衡,分別是增加資料可靠性以及增加存儲器 ( 群 ) 讀寫效能
RAID 0
RAID 0 亦稱為帶區集 ,是將多個磁碟並列起來,成為一個大磁碟,在存放數據時,其將數據按磁碟的個數來進行分段,然後同時將這些數據寫進這些盤中,所以在所有的級別中,速度是最快的
RAID 0 沒有冗餘功能,如一個磁碟 ( 物理 ) 損壞,則所有的數據都會丟失 理論上越多的磁碟效能就等於 [ 單一磁碟效能 ] x [ 磁碟數 ],但實際上受限於匯流排 I / O 瓶頸及其它因素的影響,RAID 效能會隨邊際遞減
假設一個磁碟的效能是 50 MB 每秒,兩個磁碟的 RAID 0 效能約 96 MB 每秒,三個磁碟的 RAID 0 也許是 130 MB 每秒而不是 150 MB 每秒,所以兩個磁碟的 RAID 0 最能明顯感受到效能的提升
Size = 2 x min ( S1,S2 )
但如是以軟體方式來實作 RAID,則磁碟的空間則不見得受限於此 ( 例:Linux Software RAID ),透過軟體實作可經由不同的組合而善用所有的磁碟空間
Size = sum of all disk

RAID 1
RAID 1 就是鏡像,其原理為在主硬碟上存放數據的同時也在鏡像硬碟上寫一樣的數據
當主硬碟 ( 物理 ) 損壞時,鏡像硬碟則代替主硬碟的工作,因為有鏡像硬碟做數據備份,所以 RAID 1 的數據安全性在所有的 RAID 級別上來說是最好的
但無論用多少磁碟做 RAID 1,僅算一個磁碟的容量,是所有 RAID上 磁碟利用率最低的一個級別
兩組以上的 N 個磁碟相互作鏡像,在一些多執行緒作業系統中能有很好的讀取速度,另外寫入速度有微小的降低,除非擁有相同資料的主磁碟與鏡像同時損壞,否則只要一個磁碟正常即可維持運作,可靠性最高
Size = min ( S1,S2 )

RAID 5
RAID 5 使用的是 Disk Striping ( 硬碟分割 ) 技術
RAID 5 可理解為是 RAID 0 和 RAID 1 的折衷方案,是一種儲存性能、數據安全和存儲成本兼顧的存儲解決方案,可為系統提供數據安全保障,但保障程度要比鏡像低而磁碟空間利用率要比鏡像高
RAID 5 具有和 RAID 0 相近似的數據讀取速度,只是多了一個奇偶校驗信息,寫入數據的速度相當的慢,若使用 [ 回寫快取 ] 可讓效能改善不少,同時由於多個數據對應一個奇偶校驗信息
RAID 5 至少需要三顆硬碟,不對存儲的數據進行備份,而是把數據和相對應的奇偶校驗信息存儲到組成 RAID5 的各個磁碟上且奇偶校驗信息和相對應的數據分別存儲於不同的磁碟上
當 RAID5 的一個磁碟數據發生損壞後,利用剩下的數據和相應的奇偶校驗信息去恢復被損壞的數據
Size = ( N - 1 ) x min ( S1,S2,.....,Sn )
RAID 10 / 01
RAID 10 / 01 細分為 RAID 1 + 0 或 RAID 0 + 1
效能上,RAID 0 + 1 比 RAID 1 + 0 有著更快的讀寫速度
可靠性上,當 RAID 1 + 0 有一個硬碟受損,其餘三個硬碟會繼續運作,RAID 0 + 1 只要有一個硬碟受損,同組 RAID 0 的另一硬碟亦會停止運作,只剩下兩個硬碟運作,可靠性較低
RAID 1 + 0
RAID 1+ 0 是先鏡射再分割資料,再將所有硬碟分為兩組,視為是 RAID 0 的最低組合,然後將這兩組各自視為 RAID 1 運作
RAID 0 + 1
RAID 0 + 1 是先分割再將資料鏡射到兩組硬碟,它將所有的硬碟分為兩組,變成 RAID 1 的最低組合,然後將兩組硬碟各自視為 RAID 0 運作
 Reference:
http://www.cas.idv.tw/Documents/System/RAID/RAID.asp
磁碟陣列 ( Redundant Array of Inexpensive Disks,RAID )
把多個相對便宜的硬碟組合起來,成為一個硬碟陣列組,使性能達到甚至超過一個價格昂貴、容量巨大的硬碟
根據選擇的版本不同,RAID 比單顆硬碟有以下一個或多個方面的好處:增強資料整合度,增強容錯功能,增加處理量或容量
磁碟陣列對於電腦來說, 看起來就像一個單獨的硬碟或邏輯存儲單元,分為 RAID-0,RAID-1,RAID-1E,RAID-5,RAID-6,RAID-7,RAID-10,RAID-50
RAID 把多個硬碟組合成為一個邏輯磁區,因此,作業系統只會把它當作一個硬碟,RAID 常被用在伺服器電腦上且常使用完全相同的硬碟作為組合
由於硬碟價格的不斷下降與 RAID 功能更加有效地與主機板整合,它也成為了玩家的一個選擇,特別是需要大容量儲存空間的工作
最初的 RAID 分成了不同的等級,每種等級都有其理論上的優缺點,不同的等級在兩個目標間取得平衡,分別是增加資料可靠性以及增加存儲器 ( 群 ) 讀寫效能
RAID 0
RAID 0 亦稱為帶區集 ,是將多個磁碟並列起來,成為一個大磁碟,在存放數據時,其將數據按磁碟的個數來進行分段,然後同時將這些數據寫進這些盤中,所以在所有的級別中,速度是最快的
RAID 0 沒有冗餘功能,如一個磁碟 ( 物理 ) 損壞,則所有的數據都會丟失 理論上越多的磁碟效能就等於 [ 單一磁碟效能 ] x [ 磁碟數 ],但實際上受限於匯流排 I / O 瓶頸及其它因素的影響,RAID 效能會隨邊際遞減
假設一個磁碟的效能是 50 MB 每秒,兩個磁碟的 RAID 0 效能約 96 MB 每秒,三個磁碟的 RAID 0 也許是 130 MB 每秒而不是 150 MB 每秒,所以兩個磁碟的 RAID 0 最能明顯感受到效能的提升
Size = 2 x min ( S1,S2 )
但如是以軟體方式來實作 RAID,則磁碟的空間則不見得受限於此 ( 例:Linux Software RAID ),透過軟體實作可經由不同的組合而善用所有的磁碟空間
Size = sum of all disk

RAID 1
RAID 1 就是鏡像,其原理為在主硬碟上存放數據的同時也在鏡像硬碟上寫一樣的數據
當主硬碟 ( 物理 ) 損壞時,鏡像硬碟則代替主硬碟的工作,因為有鏡像硬碟做數據備份,所以 RAID 1 的數據安全性在所有的 RAID 級別上來說是最好的
但無論用多少磁碟做 RAID 1,僅算一個磁碟的容量,是所有 RAID上 磁碟利用率最低的一個級別
兩組以上的 N 個磁碟相互作鏡像,在一些多執行緒作業系統中能有很好的讀取速度,另外寫入速度有微小的降低,除非擁有相同資料的主磁碟與鏡像同時損壞,否則只要一個磁碟正常即可維持運作,可靠性最高
Size = min ( S1,S2 )

RAID 5
RAID 5 使用的是 Disk Striping ( 硬碟分割 ) 技術
RAID 5 可理解為是 RAID 0 和 RAID 1 的折衷方案,是一種儲存性能、數據安全和存儲成本兼顧的存儲解決方案,可為系統提供數據安全保障,但保障程度要比鏡像低而磁碟空間利用率要比鏡像高
RAID 5 具有和 RAID 0 相近似的數據讀取速度,只是多了一個奇偶校驗信息,寫入數據的速度相當的慢,若使用 [ 回寫快取 ] 可讓效能改善不少,同時由於多個數據對應一個奇偶校驗信息
RAID 5 至少需要三顆硬碟,不對存儲的數據進行備份,而是把數據和相對應的奇偶校驗信息存儲到組成 RAID5 的各個磁碟上且奇偶校驗信息和相對應的數據分別存儲於不同的磁碟上
當 RAID5 的一個磁碟數據發生損壞後,利用剩下的數據和相應的奇偶校驗信息去恢復被損壞的數據
Size = ( N - 1 ) x min ( S1,S2,.....,Sn )
RAID 10 / 01
RAID 10 / 01 細分為 RAID 1 + 0 或 RAID 0 + 1
效能上,RAID 0 + 1 比 RAID 1 + 0 有著更快的讀寫速度
可靠性上,當 RAID 1 + 0 有一個硬碟受損,其餘三個硬碟會繼續運作,RAID 0 + 1 只要有一個硬碟受損,同組 RAID 0 的另一硬碟亦會停止運作,只剩下兩個硬碟運作,可靠性較低
RAID 1 + 0
RAID 1+ 0 是先鏡射再分割資料,再將所有硬碟分為兩組,視為是 RAID 0 的最低組合,然後將這兩組各自視為 RAID 1 運作
RAID 0 + 1
RAID 0 + 1 是先分割再將資料鏡射到兩組硬碟,它將所有的硬碟分為兩組,變成 RAID 1 的最低組合,然後將兩組硬碟各自視為 RAID 0 運作

http://www.cas.idv.tw/Documents/System/RAID/RAID.asp
2019年1月14日 星期一
Find 指令用法教學
筆記一下自己常用的 Find 指令
1. 找出 . 底下的 txt 檔
2. 找出 . 底下非 txt 的附檔名的檔案
3. 刪除 . 底下 txt 檔案,有兩種作法
4. 如何刪除 5 天前的資料呢?
5. 找出 5 天以內修改的資料
6. find 後只顯示目錄名稱不顯示路徑
7. find 後只顯示目錄名稱不顯示路徑,也不顯示第一個 . 目錄
8. 找尋所有檔案大小大於 50MB 的檔案
9. 找尋所有檔案大小小於 50MB 的檔案
10. 尋找超過 10 分鐘沒有被存取或修改過的檔案
11. 尋找曾經在 10 分鐘內被存取或修改過的檔案
12. 尋找檔案建立時間已超過 30 天的檔案
1. 找出 . 底下的 txt 檔
#
find . -name "*.txt"
2. 找出 . 底下非 txt 的附檔名的檔案
#
find . -not -name "*.txt"
3. 刪除 . 底下 txt 檔案,有兩種作法
#
# 系統詢問之後才刪除
# 先把 -exec 後面的東西先清掉, 用 -print 來先確認輸出 , 或將以刪除資訊寫進log
# rm 可以多用 -i 的參數來加以確認
find . -name "*.txt " -exec echo "Delete {}" \; -exec rm -i {} \;

#
#不用確認
find . -name "*.txt " -exec echo "Delete {}" \; -exec rm "{}" \;

#
# 系統直接刪除
find . -delete -name "*.txt "
find . -name "*.txt " | xargs /bin/rm -rf
4. 如何刪除 5 天前的資料呢?
#
find ${path_name} -type f -mtime +5 -exec rm "{}" \;
find ${path_name} -type f -mtime +5  | xargs /bin/rm -rf
find ${path_name} -delete -type f -mtime +5
5. 找出 5 天以內修改的資料
#
find . -type f -mtime -5 -name "*.txt"
6. find 後只顯示目錄名稱不顯示路徑
#
find . -maxdepth 1 -type d  -exec basename {} \;
find . -maxdepth 1 -type d | awk -F"/" '{print $NF}'
find . -maxdepth 1 -type d | sed 's!.*\/\([^\/]*\).*!\1!g'
7. find 後只顯示目錄名稱不顯示路徑,也不顯示第一個 . 目錄
#
find . -maxdepth 1 -mindepth 1 -type d -exec basename {} \;
8. 找尋所有檔案大小大於 50MB 的檔案
#
find ${path_name} -type f -size +50M
9. 找尋所有檔案大小小於 50MB 的檔案
#
find ${path_name} -type f -size -50M
10. 尋找超過 10 分鐘沒有被存取或修改過的檔案
#
find ${path_name} -type f -amin +10
11. 尋找曾經在 10 分鐘內被存取或修改過的檔案
#
find ${path_name} -type f -amin -10
12. 尋找檔案建立時間已超過 30 天的檔案
#
find ${path_name} -type f -ctime +30
2018年10月10日 星期三
Vim 打造成 Source Insight
環境: Debian
vim是套在Linux上非常好用的編輯軟體,但在trace code的能力上卻比不上source insight或eclipse等,但我們可以另外安裝套件,讓vim接近於source insight的使用方式,
以下使用了ctags + cscope + taglist + nerdtree + srcexpl + trinity來達成此目標
◎ Install
進入程式目錄當中,若是多層的目錄則進到最上層的目錄,接著輸入
接著必須讓vim知道tags需要到哪裡找到,先用vim打開vimrc,之後把下面第二段的資訊加進去
用vim進到.c .h檔之後移到函式或變數上即可使用快捷鍵找到該函式或變數的定義,也可跳回到使用此函式的地方
二、cscope
cscope可以查詢函式或變數在哪些地方被使用過,或是函式當中使用了哪些函式
◎ Install
◎ Usage
進入程式目錄當中,若是多層的目錄則進到最上層的目錄,接著輸入
參數說明如下
1. R : 將目錄及子目錄底下的所有文件都建立索引
2. b : 僅建立關聯數據庫,不導入使用者介面
3. q : 建立cscope.in.out和cscope.po.out,可增快搜尋速度
4. k : 不搜尋預設會include進來的函式(/usr/include)
將以下設定加入vimrc
最後附上各指令的用途
1.:cs find s {name} : 找出C語言name的符號
2.:cs find g {name} : 找出name定義的地方
3.:cs find c {name} : 找出使用name的地方
4.:cs find t {name} : 找出name的字串
5.:cs find e {name} : 相當於egrep功能,但速度更佳
6.:cs find f {name} : 尋找檔案
7.:cs find i {name} : 尋找include此檔案的檔案
8.:cs find d {name} : 尋找name裡面使用到的函式
三、taglist
taglist可在切出一區塊,顯示此檔案裡的macro,global variable,函式等資訊,且會隨著瀏覽到哪個地方便以不同顏色標示
◎ Install
下載plugin file,下載地址如下,請自行選擇最新版本下載
http://sourceforge.net/projects/vim-taglist/files/vim-taglist
將plugin/taglist.vim複製到~/.vim/plugin/,doc/taglist.txt複製到~/.vim/doc
◎ Usage
可在~/.vimrc裡配置相關設定,其他配置選項請參考官網說明
1.nmap : 將F8設為開啟taglist的快捷鍵
2.Tlist_Show_One_File : 只顯示當下瀏覽檔案的func,不顯示之前瀏覽的檔案
3.Tlist_Exit_OnlyWindow : 如果taglist區塊是最後一個,則退出vim
4.ut=100 : taglist會標示目前在操作哪個function or variable,但更新速度很慢,這裡把更新速度設成100ms
四、nerdtree
NERD tree可切出一區塊,顯示根目錄開始的檔案結構,且可由list直接跳到選取的檔
◎ Install
下載plugin file,下載地址如下,請自行選擇最新版本下載
http://www.vim.org/scripts/script.php?script_id=1658
將plugin/NERD_tree.vim複製到~/.vim/plugin/,doc/NERD_tree.txt複製到~/.vim/doc
剩下的資料夾autoload, lib, nerdtree_plugin, syntax全部複製到~/.vim底下
◎ Usage
可在~/.vimrc裡配置相關設定,其他配置選項請參考官網說明
1.nmap: 將F9設為開啟nerdtree的快捷鍵
2.NERDTreeWinPos : 將nerdtree區塊放在右邊
五、SrcExpl(Source Explorer)
SrcExpl可以將當下function的定義顯示出來,或是將當下的變數宣告處顯示出來
◎ Install
將plugin/srcexpl.vim複製到~/.vim/plugin/,doc/srcexpl.txt複製到~/.vim/doc
◎ Usage
官方網站有詳細介紹在.vimrc可用的設定,這裡只列出我有用到的設定
1.nmap : 將F10設為開啟srcexpl的快捷鍵
2.若有安裝taglist or nerdtree則需輸入
六、 trinity
trinity用來整合taglist, nerdtree, srcexpl,使可以一鍵開啟三個plgin的功能
◎ Install
將plugin/trinity.vim複製到~/.vim/plugin/
◎ Usage
接著設定vimrc
1.nmap:將F7設為一次打開taglist, nerdtree, srcexpl的快捷鍵


References:
1. http://yuanfarn.blogspot.com/2013/02/srcexpl-vim-source-explorer.html
2. https://stackoverflow.com/questions/3196760/how-to-use-cscope-with-paths-that-contain-spaces
3. http://rickey-nctu.blogspot.com/2009/02/vim-srcexpl.html
vim是套在Linux上非常好用的編輯軟體,但在trace code的能力上卻比不上source insight或eclipse等,但我們可以另外安裝套件,讓vim接近於source insight的使用方式,
以下使用了ctags + cscope + taglist + nerdtree + srcexpl + trinity來達成此目標
一、ctags
ctags可以在函式、變數之間自由進行切換,例如某主函式call了func(),ctags可以直接跳到func的函式裡面、也可使用在變數上 ◎ Install
sudo apt-get install exuberant-ctags◎ Usage
進入程式目錄當中,若是多層的目錄則進到最上層的目錄,接著輸入
ctags -R
接著必須讓vim知道tags需要到哪裡找到,先用vim打開vimrc,之後把下面第二段的資訊加進去
vim ~/.vimrc

set tags=./tags,./TAGS,tags;~,TAGS;~
用vim進到.c .h檔之後移到函式或變數上即可使用快捷鍵找到該函式或變數的定義,也可跳回到使用此函式的地方
"跳至該函式或變數定義
Ctrl + ]
"跳回使用此函式或變數處
Ctrl + t
二、cscope
cscope可以查詢函式或變數在哪些地方被使用過,或是函式當中使用了哪些函式
◎ Install
sudo apt-get install cscope
◎ Usage
進入程式目錄當中,若是多層的目錄則進到最上層的目錄,接著輸入
cscope -Rbqk
參數說明如下
1. R : 將目錄及子目錄底下的所有文件都建立索引
2. b : 僅建立關聯數據庫,不導入使用者介面
3. q : 建立cscope.in.out和cscope.po.out,可增快搜尋速度
4. k : 不搜尋預設會include進來的函式(/usr/include)
將以下設定加入vimrc
set cscopetag
set csto=0

if filereadable("cscope.out")
   cs add cscope.out
elseif $CSCOPE_DB != ""
    cs add $CSCOPE_DB
endif
set cscopeverbose

nmap zs :cs find s =expand("")
nmap zg :cs find g =expand("")
nmap zc :cs find c =expand("")
nmap zt :cs find t =expand("")
nmap ze :cs find e =expand("")
nmap zf :cs find f =expand("")
nmap zi :cs find i ^=expand("")$
nmap zd :cs find d =expand("")
最後附上各指令的用途
1.:cs find s {name} : 找出C語言name的符號
2.:cs find g {name} : 找出name定義的地方
3.:cs find c {name} : 找出使用name的地方
4.:cs find t {name} : 找出name的字串
5.:cs find e {name} : 相當於egrep功能,但速度更佳
6.:cs find f {name} : 尋找檔案
7.:cs find i {name} : 尋找include此檔案的檔案
8.:cs find d {name} : 尋找name裡面使用到的函式
三、taglist
taglist可在切出一區塊,顯示此檔案裡的macro,global variable,函式等資訊,且會隨著瀏覽到哪個地方便以不同顏色標示
◎ Install
下載plugin file,下載地址如下,請自行選擇最新版本下載
http://sourceforge.net/projects/vim-taglist/files/vim-taglist
將plugin/taglist.vim複製到~/.vim/plugin/,doc/taglist.txt複製到~/.vim/doc
◎ Usage
可在~/.vimrc裡配置相關設定,其他配置選項請參考官網說明
nmap<F8>:TlistToggle
let Tlist_Show_One_File=1
let Tlist_Exit_OnlyWindow=1
set ut=100
1.nmap : 將F8設為開啟taglist的快捷鍵
2.Tlist_Show_One_File : 只顯示當下瀏覽檔案的func,不顯示之前瀏覽的檔案
3.Tlist_Exit_OnlyWindow : 如果taglist區塊是最後一個,則退出vim
4.ut=100 : taglist會標示目前在操作哪個function or variable,但更新速度很慢,這裡把更新速度設成100ms
四、nerdtree
NERD tree可切出一區塊,顯示根目錄開始的檔案結構,且可由list直接跳到選取的檔
◎ Install
下載plugin file,下載地址如下,請自行選擇最新版本下載
http://www.vim.org/scripts/script.php?script_id=1658
將plugin/NERD_tree.vim複製到~/.vim/plugin/,doc/NERD_tree.txt複製到~/.vim/doc
剩下的資料夾autoload, lib, nerdtree_plugin, syntax全部複製到~/.vim底下
◎ Usage
可在~/.vimrc裡配置相關設定,其他配置選項請參考官網說明
nmap<F9>:NERDTreeFind
let NERDTreeWinPos=1
1.nmap: 將F9設為開啟nerdtree的快捷鍵
2.NERDTreeWinPos : 將nerdtree區塊放在右邊
五、SrcExpl(Source Explorer)
SrcExpl可以將當下function的定義顯示出來,或是將當下的變數宣告處顯示出來
◎ Install
git clone https://github.com/wesleyche/SrcExpl
將plugin/srcexpl.vim複製到~/.vim/plugin/,doc/srcexpl.txt複製到~/.vim/doc
◎ Usage
官方網站有詳細介紹在.vimrc可用的設定,這裡只列出我有用到的設定
nmap<F10>:SrcExplTogglelet g:SrcExpl_pluginList = [ \ "__Tag_List__", \ "_NERD_tree_", \ "Source_Explorer" \ ]
1.nmap : 將F10設為開啟srcexpl的快捷鍵
2.若有安裝taglist or nerdtree則需輸入
六、 trinity
trinity用來整合taglist, nerdtree, srcexpl,使可以一鍵開啟三個plgin的功能
◎ Install
git clone https://github.com/wesleyche/Trinity
將plugin/trinity.vim複製到~/.vim/plugin/
◎ Usage
接著設定vimrc
nmap:TrinityToggleAll
1.nmap:將F7設為一次打開taglist, nerdtree, srcexpl的快捷鍵


References:
1. http://yuanfarn.blogspot.com/2013/02/srcexpl-vim-source-explorer.html
2. https://stackoverflow.com/questions/3196760/how-to-use-cscope-with-paths-that-contain-spaces
3. http://rickey-nctu.blogspot.com/2009/02/vim-srcexpl.html
2018年6月4日 星期一
Verilog - 7段顯示器(SEG7)
----a-----
| |
f b
| |
----g-----
| |
e c
| |
----d-----

當7段顯示器 燈號 active LOW
ex. 0 => a,b,c,d,e,f = 0 , g = 1
| |
f b
| |
----g-----
| |
e c
| |
----d-----

當7段顯示器 燈號 active LOW
ex. 0 => a,b,c,d,e,f = 0 , g = 1
module SEG7_LUT (
   input [3:0] iDIG,
   output reg [6:0] oSEG
);

always@(iDIG) begin
  case(iDIG)
    4'h1: oSEG = 7'b1111001;  // ---a----
    4'h2: oSEG = 7'b0100100;  // |      |
    4'h3: oSEG = 7'b0110000;  // f      b
    4'h4: oSEG = 7'b0011001;  // |      |
    4'h5: oSEG = 7'b0010010;  // ---g----
    4'h6: oSEG = 7'b0000010;  // |      |
    4'h7: oSEG = 7'b1111000;  // e      c
    4'h8: oSEG = 7'b0000000;  // |      |
    4'h9: oSEG = 7'b0011000;  // ---d----
    4'ha: oSEG = 7'b0001000;
    4'hb: oSEG = 7'b0000011;
    4'hc: oSEG = 7'b1000110;
    4'hd: oSEG = 7'b0100001;
    4'he: oSEG = 7'b0000110;
    4'hf: oSEG = 7'b0001110;
    4'h0: oSEG = 7'b1000000;
  endcase
end
endmodule
2018年6月2日 星期六
Cryptography
何謂密碼學?

密碼學為一種利用數學方法來對資料加密和解密的科學。密碼系統是由明文、加密演算法、金鑰、解密演算法及密文組合而成。
明文(Plaintext) →加密前的原始資料,為加密演算法的輸入,解密演算法的輸出。
密文(Ciphertext) →加密之後的資料,為加密演算法的輸出,解密演算法的輸入。
加密演演算法(Encryption Algorithm)
利用密鑰對明文進行加密的編碼動作的演算法。
解密演算法(Decryption Algorithm)
利用金鑰對密文進行解密的解碼動作的演算法。
解密(Decipher)
將密文還原為明文的過程。
密碼破解(Cryptanalysis)
不需經由加密金鑰或使用偽造金鑰即能夠將密文解原還為明文稱之。

※加密技術的強度指的是密碼破解所需要花費的時間與資源。加密技術強度的高低通常牽涉到下列的因素:
(1)演算法強度
(2)金鑰保護機制
(3)金鑰的長度
※密碼系統的安全與否的衡量標準在於破解者需要花費多少時間以及多少成本才能夠破解。
(1)破解所需要的成本高於該訊息的價值
(2)破解所需要的時間超過該金鑰的壽命
※密碼破解技術分為下列幾種:
(1)只知密文破解(Ciphertext
Only Attack)
破解者藉由蒐集所有可能的密文以找出明文或金鑰。
(2)已知明文破解(Known
Plaintext Attack)
破解者藉由已知的明文與其相對應的密文以找出金鑰。
(3)選擇明文破解(Chosen
Plaintext Attack)
攻擊者利用特殊方法將明文發送給傳送端,再由傳送者取得加密後的密文(即破解者可以控制明文與其相對應的密文) ,以找出加密金鑰。
(4)選擇密文破解(Chosen
Ciphertext Attack)
攻擊者利用特殊方法將密文發送給接收端,再由接收者取得解密後的明文(即破解者可以控制密文與其相對應的明文) ,以找出加密金鑰。
(5)暴力破解法(Brute-Force
Attack)
破解者嘗試所有可能的私密金鑰來攻擊密碼系統。
※非技術破解
(1)
社交工程(Social
Engineering)
利用人性的弱點達到密碼騙取。
(2)
身旁側視(Shoulder Surfing)
在身旁看使用者輸入密碼,成功機率很高。
密碼學系統通常可以根據三種不同的觀點來分類:
一、將明文轉換為密文所使用運算方法上的差異:
(1)取代(substitution)
(2)置換(transposition)
(3)相乘(product)
二、使用金鑰個數的差異:
(1)私密鑰匙(secret-key),或傳統加密系統
(2)非對稱性或公開鑰匙加密系統
(3)雜湊(HASH)
三、處理明文方法上的差異:
(1)資料區段加密法(block cipher)
(2)資料流加密法(stream cipher)
第一大類-運算方法上的差異
(1)取代(substitution)
取代指的是明文中的每一個元素都被對應到另一個元素。
(2)置換(transposition)
置換是將明文中的元素重新排列。
(3)相乘(Product)
以取代與置換為基礎構成的複雜組合,以達到更複雜的相乘效果。
第二大類-金鑰個數的差異
(1)對稱性密碼學
加密與解密使用同一把金鑰稱之,又稱為單一或私密鑰匙(secret-key),或傳統加密系統。
(2)非對稱性或公開鑰匙加密系統
加密與解密使用一對金鑰稱之
(3)不需要金鑰的加密技術稱為雜湊(HASH)
第三大類-處理明文方法的差異
(1)資料區段加密法(block cipher)
將明文分成數個n個字元或位元的區段,並且對每一個區段資料應用相同的演算法則和鑰匙,數學式表示為(M為明文,分割成M1、M2… Mn區段)
如E(M,K)=E(M1,K)E(M2,K)… ..E(Mn,K)
(2)資料流加密法(stream cipher)
資料流加密並不會將明文切分為區段,而是一次加密資料流的一個位元或是位元組。常見的作法是將較短的加密鑰匙延展成為無限長、近似亂碼的一長
串金鑰串流(keystream),再將金鑰串流和原始資料(plain text)經過XOR運算後,產生密文資料(cipher
text)。
比較對稱性密碼學與非對稱性密碼學
對稱性密碼學又稱為傳統或秘密金鑰(Symmetric Encryption)
(1)訊息的加密和解密採用相同的金鑰
(2)需要傳送和接收雙方均擁有相同的一把金鑰
優點:
1.較快速
2.如果使用足夠大的金鑰,將難以破解。
缺點:
1.需要有一個安全性機制將金鑰安全性的分送至交易的雙方。
2.提供私密性(Confidential)的安全性能力,無法提供不可否認的能力
非對稱性密碼學(Asymmetric Encryption)
每個使用者擁有一對金鑰-公開金鑰和私密金鑰(public
keyand a private key),訊息由其中一把金鑰加密後,必需由另一把金鑰予以解密,公開金鑰可以被廣泛的發佈,而私密金鑰必需隱密的加以保存。
優點:
1.公開鑰匙可以公開分送
2.提供私密性、驗證與不可否認性等服務
缺點:
1.效率較差
2018年5月3日 星期四
陣列與鏈結串列
結構陣列
※ 優點 -> 使用容易
※ 缺點 -> (1)刪除與插入造成資料移動頻繁
(2)浪費不必要之記憶體
(3)陣列長度為常數,可能不夠用

鏈結串列

◎ 鏈結串列節點
節點:鏈結串列中最基本的單位

節點 = 資料 + 結構指標
◎ 定義鏈結串列節點結構
鏈結串列透過儲存元素在記憶體之位址為指標(Pointer)或鏈結(Link)取得下一個節點。
定義節點結構:

◎ 單向鏈結串列
head : 指向串列前端之指標


★ 新增節點
在新增節點時,最好是使用動態配置一節點之記憶體。
★ 釋放節點
當然在使用完畢記得歸還一個節點之記憶體。
★ 插入節點
由鏈結串列加入一個節點,一個節點插入有三種情況:
◆ 節點加於第一個節點之前

head = (node *)malloc(sizeof(node));
head -> next = ptr;
ptr = head;
◆ 節點加於最後一個節點之後
 ptr
ptr->next = (node *)malloc(sizeof(node));
ptr = ptr->next;
◆ 加於節點中間任何一個位置

node *new_node; //(1)
new_node = getnode(); //(2)
new_node->next = ptr->next; //(3)
/* 新節點指向下一節點*/
ptr->next = new_node; //(4)
/* 節點ptr指向新節點*/
★ 尋找節點
走訪串列,將找到節點位置回傳。
★ 刪除節點
由鏈結串列中刪除一個節點,一個節點刪除有三重情況:
◆ 刪除第一個節點

head = head->next;
freenode(ptr);
return(head); /* reset 起始節點指標 */
◆ 刪除最後一個節點
 ptr
previous = head;
while ( previous->next != ptr ) /* 找節點ptr的前節點 */
previous = previous->next;
previous->next = NULL; /* 最後一個節點 */
freenode(ptr); /* 此函數將節點歸還給記憶體 */
◆ 刪除中間任何一個節點

※ 優點 -> 使用容易
※ 缺點 -> (1)刪除與插入造成資料移動頻繁
(2)浪費不必要之記憶體
(3)陣列長度為常數,可能不夠用

#include<stdio.h>

struct student
{
 int math;
 int eng;
 int comp;
};
typedef struct student student;

int main(){

 student s[5];
 int sum[3] = {0};
 int i;
 int n = 0;
 int op,qid;

 while(1){

  puts("(1) 新增一位同學資料");
  puts("(2) 查詢某位同學成績 (輸入座號)");
  puts("(3) 修改某位同學成績 (輸入座號)");
  puts("(4) 列出所有資料");
  puts("(5) 計算各科平均");
  puts("(6) 計算某位同學成績平均 (輸入座號)");
  puts("(0) 離開");


  scanf("%d", &op);
  switch(op)
  {
   case 1:
    scanf("%d", &s[n].math);
    scanf("%d", &s[n].eng);
    scanf("%d", &s[n].comp);
    n++;
    break;
   case 2:
    scanf("%d", &qid);
    if(qid>0 && qid<=n)
    {

     printf("%d\n", s[qid-1].math);
     printf("%d\n", s[qid-1].eng);
     printf("%d\n", s[qid-1].comp);
    }
    else
    {
     printf("無此座號\n");
    }
    break;
   case 3:
    scanf("%d", &qid);
    if(qid>0 && qid<=n)
    {
     scanf("%d\n", &s[qid-1].math);
     scanf("%d\n", &s[qid-1].eng);
     scanf("%d\n", &s[qid-1].comp);
    }
    else
    {
     printf("無此座號\n");
    }

    break;
   case 4:
     for(i=0; i<n; i++){
         printf("%d\n", s[i].math);
         printf("%d\n", s[i].eng);
         printf("%d\n", s[i].comp);
     }
    break;
   case 5:
    //算各科總分
    for(i=0;i<n;i++){
     sum[0] += s[i].math;
     sum[1] += s[i].eng;
     sum[2] += s[i].comp;
    }

    for(i=0;i<3;i++){
     printf("%.2f\n", (double)sum[i]/n);
    }
    break;
   case 6:
    scanf("%d", &qid);
    if(qid>0 && qid<=n)
    {

     printf("%.2f\n", (double)(s[qid-1].math + s[qid-1].eng + s[qid-1].comp)/3);
    }
    else
    {
     printf("無此座號\n");
    }
    break;
   case 0:
    return 0;
    break;
  }

 }
 return 0;
}
鏈結串列

節點:鏈結串列中最基本的單位
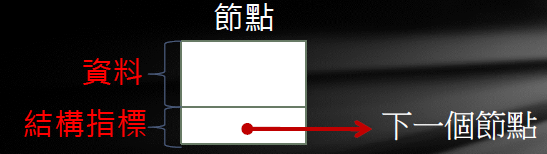
節點 = 資料 + 結構指標
◎ 定義鏈結串列節點結構
鏈結串列透過儲存元素在記憶體之位址為指標(Pointer)或鏈結(Link)取得下一個節點。
定義節點結構:

head : 指向串列前端之指標

◎ 連續鏈結串列
node *head, *ptr;
head = (node *)malloc(sizeof(node));
ptr = head;
int value;
scanf("%d", &value);
ptr->data = value;
ptr->next = (node
*)malloc(sizeof(node));
ptr = ptr->next;

★ 新增節點
在新增節點時,最好是使用動態配置一節點之記憶體。
node *getnode () /* 此函數產生一個新節點 */
{
 node *p;
 p = (node *) malloc(sizeof(node));
 /* malloc 會動態地配置大小為sizeof 的記憶體*/
 /* sizeof 會傳回一個型態為node之值*/
 if ( p == NULL)
 {
  printf ("記憶體不足");
  exit(1);
 }
 return(p);
}
★ 釋放節點
當然在使用完畢記得歸還一個節點之記憶體。
void freenode (node *p) /* 此函數將節點還給記憶體 */
{
         free(p);
}
★ 插入節點
由鏈結串列加入一個節點,一個節點插入有三種情況:
◆ 節點加於第一個節點之前
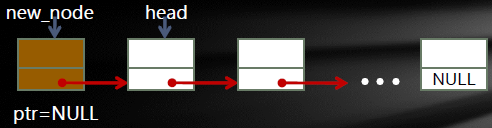
head = (node *)malloc(sizeof(node));
head -> next = ptr;
ptr = head;
◆ 節點加於最後一個節點之後
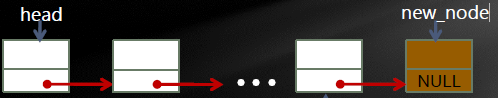
ptr->next = (node *)malloc(sizeof(node));
ptr = ptr->next;
◆ 加於節點中間任何一個位置

node *new_node; //(1)
new_node = getnode(); //(2)
new_node->next = ptr->next; //(3)
/* 新節點指向下一節點*/
ptr->next = new_node; //(4)
/* 節點ptr指向新節點*/
node *insert_node (node *head, node *ptr, node data)
{
 node *new_node; /* 新節點指標變數 */
 new_node = getnode(); /* 建立新節點,取得一個可用節點 */
 *new_node = data; /* 建立節點內容 */
 new_node->next = NULL; /* 設定指標初值 */
 if ( ptr == NULL ) /* 指標ptr是否是NULL */
 {
  /* 第一種情況: 插入第一個節點 */
  new_node->next = head; /* 新節點成為串列開始 */
  head = new_node;
 }
 else
 {
  if ( ptr->next == NULL ) /* 是否是串列結束 */
   /* 第二種情況: 插入最後一個節點 */
   ptr->next = new_node; /* 最後指向新節點 */
  else
  {
   /* 第三種情況: 插入成為中間節點 */
   new_node->next = ptr->next; /* (3) 新節點指向下一節點 (3)*/
   ptr->next = new_node; /* 節點ptr指向新節點 (4)*/
  }
 }
 return (head);
}
★ 尋找節點
走訪串列,將找到節點位置回傳。
node *find_node(node *head, int num)
{
 node *ptr;
 ptr = head; /* 指向串列起始 */
 while ( ptr != NULL ) /* 走訪串列 */
 {
  if ( ptr->data == num ) /* 找尋data */
   return (ptr);
   ptr = ptr->next; /* 指向下一節點 */
 }
 return (ptr);
}
★ 刪除節點
由鏈結串列中刪除一個節點,一個節點刪除有三重情況:
◆ 刪除第一個節點

head = head->next;
freenode(ptr);
return(head); /* reset 起始節點指標 */
◆ 刪除最後一個節點

previous = head;
while ( previous->next != ptr ) /* 找節點ptr的前節點 */
previous = previous->next;
previous->next = NULL; /* 最後一個節點 */
freenode(ptr); /* 此函數將節點歸還給記憶體 */
◆ 刪除中間任何一個節點

previous = head;
while ( previous->next != ptr ) /* 找節點ptr的前節點 */
previous = previous->next;
/* 第三種情況: 刪除中間節點 */
previous->next = ptr->next; //(1)
freenode(ptr); //(2) /* 此函數將節點歸還給記憶體 */
/*
 *  使用鏈結串列製作一個 會員資料表功能
 * ‧輸入’i’ 新增節點在串列最後,可輸入姓名, 電話, Email
 * ‧輸入’d’接著輸入姓名,可將節點中之姓名相同者刪除(假設輸入之姓名不會重覆)
 * ‧輸入’f’接著輸入一個姓名,可將節點中之姓名相同者印出資料
 * ‧輸入’l’ 印出串列所有節點內容並顯示目前人數
 * ‧輸入’q’ 離開程式
 *
 * 提示: 使用strcmp來實作 (string.h )
 * strcmp(data[0], data[0])
 * 第一個字串大於第二個字串回傳正值,反之回傳負值。相等則為0
 * ※bonus:可設計插入位置於最前/中間/最後
 */

#include <stdlib.h>
#include <stdio.h>
#include <string.h>

struct _node{
    int data;
    char name[80];
    int phone;
    char email[80];
    struct _node *next;
};

typedef struct _node node;

node *getnode(){
    node *p;
    p = (node *) malloc(sizeof(node));

    if(p == NULL){
        printf ("記憶體不足");
        exit(1);
    }
    return(p);
}

void freenode (node *p){
    free(p);
}

node *insert_node (node *head, node *ptr, node data){
    node *new_node;
    new_node = getnode();
    *new_node = data;      /* 建立節點內容 */
    new_node->next = NULL; /* 設定指標初值 */

    if (ptr == NULL) {
        new_node->next = head; /* 新節點成為串列開始 */
        head = new_node;
    }

    else{
        if (ptr->next == NULL)
            ptr->next = new_node; /*插入最後一個節點 */

        else{
            new_node->next = ptr->next; /*插入成為中間節點 */
            ptr->next = new_node;
        }
    }
    return (head);
}

node *find_node(node *head, char name[]){
    node *ptr;
    ptr = head;
    while (ptr != NULL){
        if (strcmp(ptr->name ,name)== 0)
            return (ptr);
        ptr = ptr->next;
    }
    return (ptr);
}

node *delete_node(node *head, node *ptr){
    node *previous;
    if (ptr == head)
        head = head->next;  /*刪除第一個節點 */

    else{
        previous = head;

        while (previous->next != ptr)
            previous = previous->next;

        if (ptr->next == NULL)
            previous->next = NULL; /*刪除最後一個節點 */

        else
            previous->next = ptr->next; /*刪除中間節點 */
    }
    freenode(ptr);
    return(head);
}

int length (node *head){
    int num=0;
    node *q = head;
    while (q != NULL) {
        num ++;
        q = q->next;
    }
    return(num);
}

int main()
{
    node *head, *ptr, input;
    head = NULL;
    int value;
    char name[80];
    char key;

    while(1){

        puts("i insert at last");
        puts("d delete");
        puts("f find");
        puts("q exit");
        puts("g length");
        puts("l list all data");

        scanf(" %c", &key);
        switch(key)
        {
            case 'i':
                scanf("%s", input.name);
                scanf("%s", input.email);
                scanf("%d", &input.phone);

                if(head==NULL)
                    head = insert_node (head, NULL, input);

                else{
                    ptr = head;
                    while(ptr->next!=NULL)
                        ptr = ptr->next;
                    head = insert_node (head, ptr, input);
                }

                break;

            case 'd':
                scanf("%s", name);
                ptr = find_node(head, name);
                if(ptr==NULL)
                    printf("Can not delete\n");

                else{
                    head = delete_node(head, ptr);
                    printf("Delete ok\n");
                }

                break;

            case 'f':
                scanf("%s", name);
                ptr = find_node(head, name);
                if(ptr==NULL)
                    printf("Not found\n");

                else{
                    printf("found\n");
                    printf("%s\n", ptr->name);
                    printf("%s\n", ptr->email);
                    printf("%010d\n\n", ptr->phone);
                }

                break;

            case 'g':
                printf("%d\n", length(head) );

                break;

            case 'l':
                ptr = head;

                while(ptr!=NULL){
                    printf("%s\n", ptr->name);
                    printf("%s\n", ptr->email);
                    printf("%010d\n\n", ptr->phone);
                    ptr = ptr->next;
                }

                break;

            case 'q':
                return 0;
                break;
        }

        system("pause");
        system("cls");

    }

    return 0;
}
訂閱:
文章 (Atom)